Jak działa noindex?
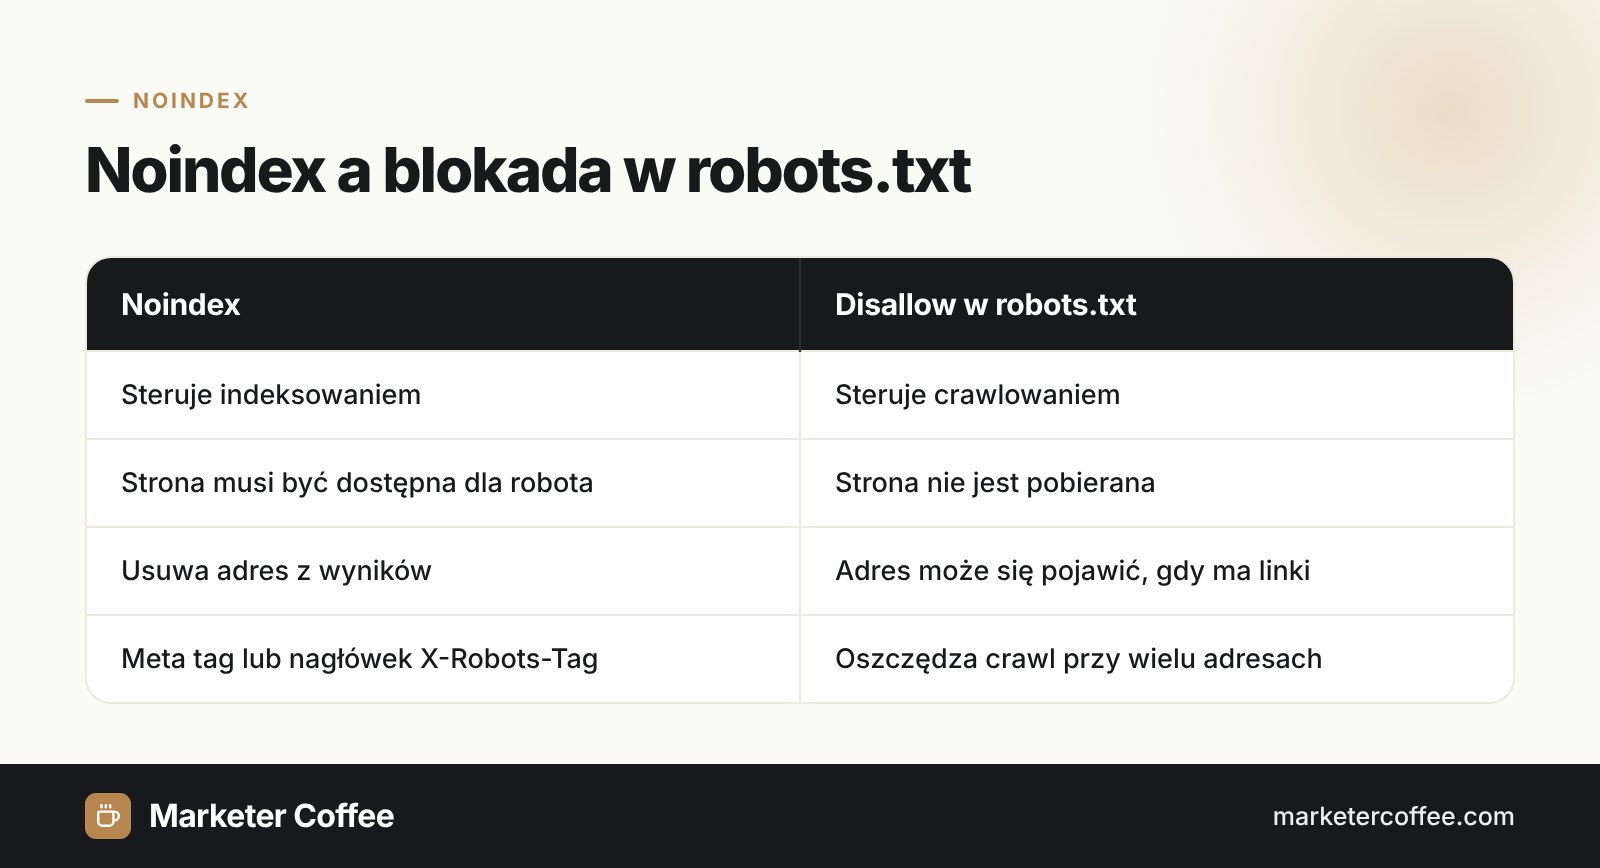
Noindex działa tak, że pozwala robotowi pobrać stronę, ale zabrania dodania jej do indeksu wyszukiwarki. Googlebot pobiera adres, znajduje regułę w sekcji head lub w nagłówkach odpowiedzi i usuwa stronę z wyników. Crawlowanie i indeksowanie to osobne etapy: noindex steruje drugim, a robots.txt pierwszym.
Składnia noindex: meta tag i X-Robots-Tag
Google akceptuje 2 równoważne sposoby ustawienia noindex: meta tag robots w HTML i nagłówek HTTP X-Robots-Tag. Nagłówek to jedyna opcja dla plików PDF, obrazów i innych plików spoza HTML.
Meta tag robots
Umieść tag w sekcji head strony:
- <meta name=”robots” content=”noindex”> dla wszystkich wyszukiwarek obsługujących regułę
- <meta name=”googlebot” content=”noindex”> tylko dla Google
- <meta name=”robots” content=”noindex, nofollow”>, by dodatkowo zablokować podążanie za linkami (none to skrót Google dla obu reguł)
Nagłówek X-Robots-Tag
Wyślij regułę w odpowiedzi serwera, np. X-Robots-Tag: noindex. Możesz ją zawęzić do jednego robota: X-Robots-Tag: googlebot: noindex. W Apache to linia Header set w pliku .htaccess, a w Nginx dyrektywa add_header dla danej lokalizacji.
Noindex a robots.txt: klasyczny błąd
Noindex i blokada w robots.txt wzajemnie się znoszą, gdy dotyczą tego samego adresu. Jeśli robots.txt blokuje stronę, Googlebot jej nie pobiera, nie widzi noindex i może nadal pokazywać sam adres, gdy linkują do niego inne strony. Google zakończył obsługę linii noindex w robots.txt 1 września 2019 roku, a zapowiedział to 1 lipca 2019 roku. Jako alternatywy wskazał meta tag lub nagłówek noindex, kody 404 i 410, ochronę hasłem, blokadę w robots.txt oraz narzędzie do usuwania adresów w Search Console.
| Cel | Rozwiązanie |
|---|---|
| strona poza wynikami | noindex, crawlowanie dozwolone |
| oszczędność crawlu przy ogromnej liczbie adresów | blokada w robots.txt |
| szybkie, tymczasowe usunięcie adresu | narzędzie do usuwania w Search Console |
| trwałe usunięcie strony | kod 404 lub 410 |
Kiedy stosować noindex w SEO?
Stosuj noindex na stronach potrzebnych użytkownikom, na które nikt nie powinien trafiać z wyszukiwarki. Typowe przykłady to:
- wyniki wyszukiwarki wewnętrznej i ubogie kombinacje filtrów,
- koszyk, kasa, konto klienta i strona podziękowania,
- wersje testowe i landing page kampanii tworzone tylko pod ruch płatny,
- archiwa tagów i strony autorów bez unikalnej wartości.
Nie używaj noindex do walki z duplikacją treści w obrębie jednej witryny. Google Search Central wymienia to jako błąd, bo noindex całkowicie usuwa stronę, zamiast przekazać sygnały na adres z tagu canonical. Nigdy nie łącz noindex z canonical wskazującym inny adres, bo te sygnały sobie przeczą.
Noindex w serwisach międzynarodowych
W serwisach wielojęzycznych noindex to częsta i cicha przyczyna znikania całych rynków. Strona z noindex nie może być poprawnym celem hreflang, więc cały zestaw językowy traci tę wersję. Google zaznacza też, że reguły meta robots i robots.txt powinny być takie same dla każdej wersji lokalnej. Przy wdrożeniach na Niemcy i Czechy najczęstszy incydent to nowy katalog /de/ lub /cz/ uruchomiony z noindex pozostawionym w szablonie z wersji testowej; w raporcie indeksowania stron w Search Console widać go jako strony wykluczone przez tag noindex. Załóż osobną usługę w Search Console dla każdego katalogu rynkowego, by widzieć takie błędy osobno dla każdego kraju.
Noindex a wyszukiwarki AI
Noindex usuwa stronę także z funkcji AI w Google, bo strony w AI Overviews i trybie AI muszą być zaindeksowane i kwalifikować się do fragmentu. Bing i inne wyszukiwarki także respektują noindex, ale każda interpretuje go po swojemu, więc sprawdzaj reguły osobno, gdy rynek zależy od Binga, Seznamu czy Yandexa.
Reguły indeksowania sprawdzam w każdym przeglądzie technicznego SEO i przy każdym starcie rynku w ramach doradztwa w zakresie międzynarodowego SEO.
Najczęstsze pytania: Noindex
Czym różni się noindex od nofollow?
Noindex wyklucza stronę z wyników wyszukiwania, a nofollow zabrania robotom podążania za linkami na tej stronie. Obie reguły można połączyć w jednym meta tagu.
Czy można wpisać noindex w robots.txt?
Nie, Google przestał obsługiwać noindex w robots.txt 1 września 2019 roku. Zamiast tego użyj meta tagu robots lub nagłówka X-Robots-Tag na stronie dostępnej dla robota.
Po jakim czasie działa noindex?
Noindex działa po ponownym crawlowaniu strony przez Googlebota, co trwa od kilku dni do kilku miesięcy zależnie od znaczenia strony. Możesz to przyspieszyć narzędziem do sprawdzania adresów URL.
Czy noindex usuwa stronę z AI Overviews?
Tak, Google wymaga, by strony w funkcjach AI były zaindeksowane i kwalifikowały się do fragmentu. Strona z noindex nie pojawi się w AI Overviews ani w trybie AI.
Powiązane pojęcia
- Block Search indexing with noindex · Google Search Central
- Robots meta tag, data-nosnippet, and X-Robots-Tag specifications · Google Search Central
- A note on unsupported rules in robots.txt · Google Search Central Blog
- Google to stop supporting noindex directive in robots.txt · Search Engine Land
- How to specify a canonical URL with rel="canonical" and other methods · Google Search Central
- <meta name="robots"> · MDN Web Docs