Co uznaje się za duplicate content?
Duplicate content to każdy blok treści głównej, do którego wyszukiwarka dociera pod dwoma lub więcej adresami URL. Google łączy takie strony w grupę i pokazuje tylko jedną z nich, co nazywa się deduplikacją. Duplikat może być dokładny (ta sama strona z ?utm_source=newsletter) albo prawie identyczny (dwie kategorie sklepu różniące się tylko sortowaniem). Tłumaczenia nie są duplikatami, pod warunkiem że przetłumaczono treść główną; strona z przetłumaczonym tylko menu i stopką nadal jest duplikatem.
5 najczęstszych przyczyn duplikacji treści
Google Search Central wymienia 5 typowych źródeł zduplikowanych adresów, a większość z nich ma charakter techniczny, nie redakcyjny:
- Warianty regionalne: ta sama treść po niemiecku dla Niemiec i Austrii pod osobnymi adresami.
- Warianty urządzeń: osobne strony mobilne (m.) i desktopowe.
- Warianty protokołu: HTTP i HTTPS albo wersja z www i bez www.
- Funkcje serwisu: sortowanie, filtrowanie i paginacja w kategoriach sklepu.
- Warianty przypadkowe: wersje testowe lub demo otwarte dla robotów.
Bing dodaje do tej listy parametry URL, ukośnik na końcu adresu, wielkość liter, wersje do druku i masową syndykację treści.
Czy za duplicate content jest kara?
Za duplicate content nie ma automatycznej kary, ale jest utrata widoczności. Google pisze, że część duplikacji jest normalna i nie narusza zasad dotyczących spamu; Bing w grudniu 2025 roku napisał, że duplikaty same w sobie nie wywołują kar. Koszt jest pośredni: linki i zaangażowanie rozkładają się na kilka adresów, Google może pokazać adres, którego nie wybrałeś, a roboty marnują budżet indeksowania na kopie. Wyjątkiem jest celowe kopiowanie. Zasady Google traktują scrapowane treści, czyli przedruk tekstów z innych stron bez wartości dodanej, jako spam.
Duplicate content w serwisach międzynarodowych
Serwisy międzynarodowe tworzą duplikaty zawsze, gdy dwa rynki dzielą jeden język: de-DE, de-AT i de-CH albo en-GB i en-US. Przewodnik Google o witrynach wieloregionalnych zaleca wybór preferowanej wersji i połączenie tagu canonical z hreflang. Każda wersja ma canonical na siebie, a hreflang wskazuje Google, którą pokazać w którym kraju. Bing idzie dalej i radzi realnie różnicować strony regionalne: lokalną terminologią, przepisami, przykładami i danymi produktów.
W moich projektach na Niemcy i Austrię austriackie strony, które różnią się od niemieckich tylko dopiskiem o cenie, zwykle lądują w jednej grupie z niemieckimi. Strony z lokalną dostawą, cenami i informacjami prawnymi pozostają osobne. Tak samo dzieje się z czeskim i słowackim sklepem zbudowanym z jednego szablonu, więc prawdziwym rozwiązaniem jest lokalizacja, a nie same tagi.
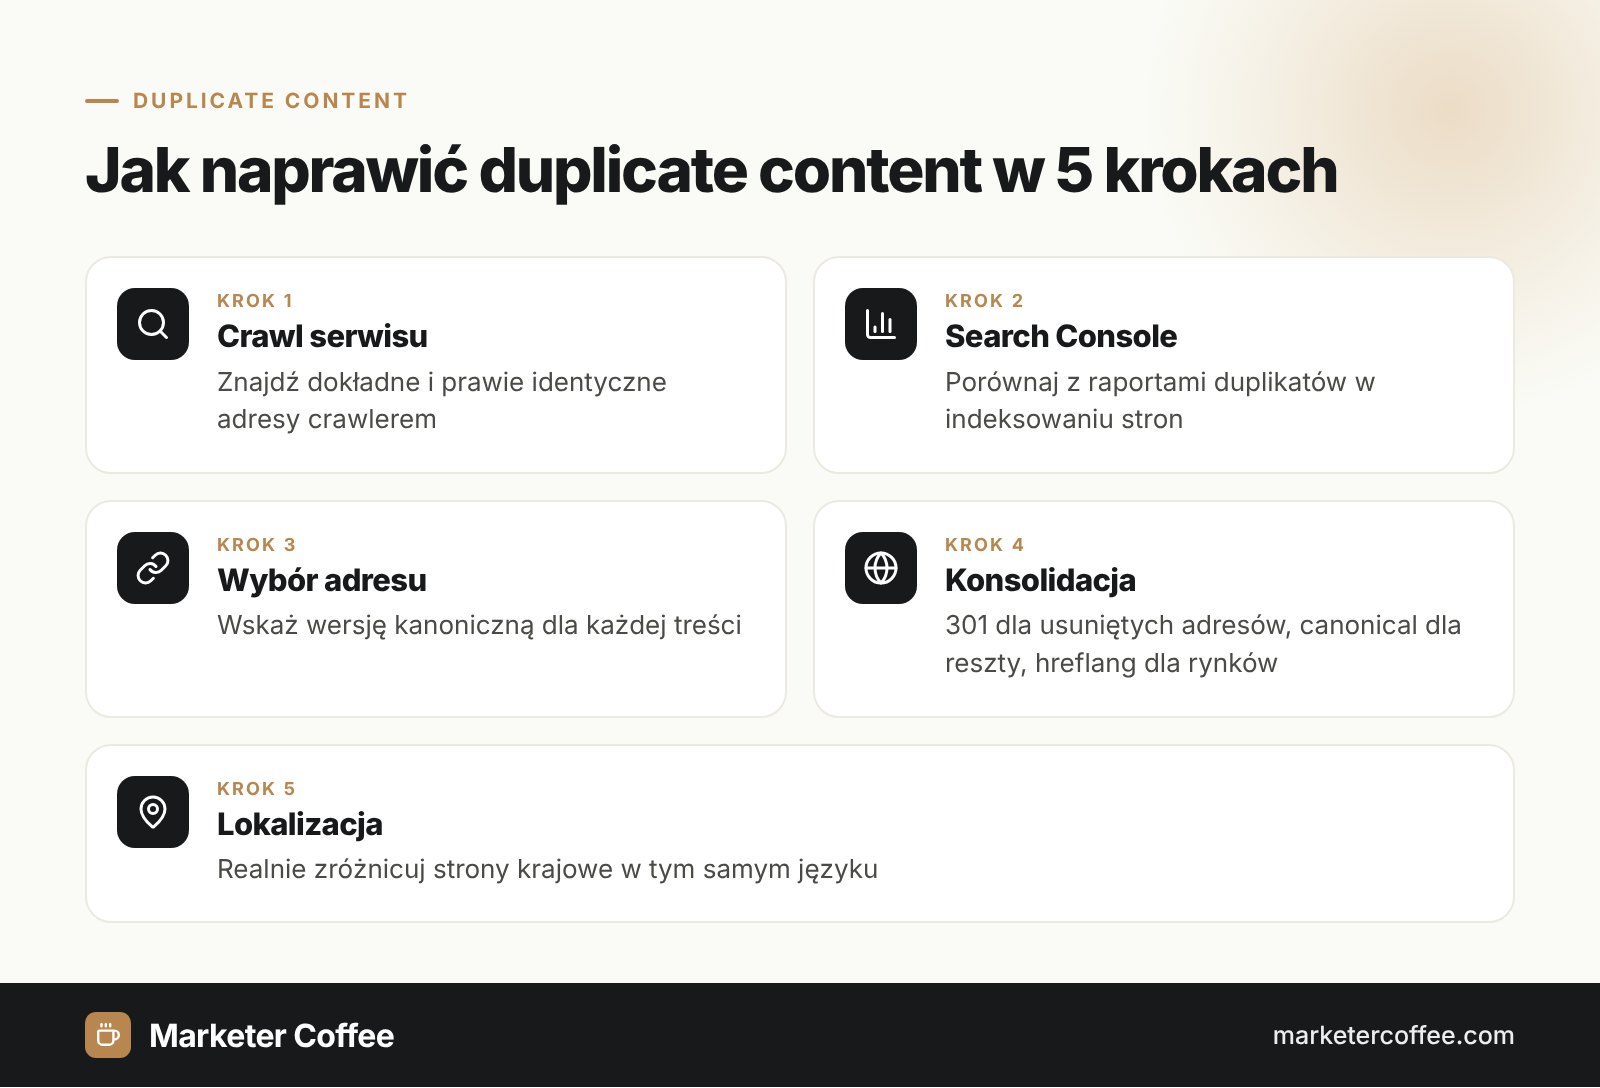
Jak naprawić duplicate content?
Duplicate content naprawiasz, wybierając jeden adres dla danej treści i kierując na niego wszystkie pozostałe sygnały. Tabela łączy sytuację z właściwym narzędziem:
| Sytuacja | Rozwiązanie |
|---|---|
| stara lub scalona strona | przekierowanie 301 na adres główny |
| filtry, UTM, wersje do druku | rel=”canonical” na czysty adres |
| wersje krajowe w jednym języku | self-canonical, hreflang i lokalna treść |
| wersja testowa, wyszukiwarka wewnętrzna | noindex lub hasło |
| artykuły syndykowane | canonical między domenami lub zajawka z linkiem |
Google przestrzega też przed 2 popularnymi skrótami: blokowaniem duplikatów w robots.txt (Googlebot nie zobaczy wtedy canonical) i używaniem noindex do wyboru strony kanonicznej w obrębie witryny. Duplikaty celujące w tę samą frazę prowadzą do pokrewnego problemu, czyli kanibalizacji słów kluczowych.
Duplicate content a wyszukiwarki AI
Duplikacja szkodzi widoczności w AI, bo odpowiedzi AI powstają na tym samym indeksie i tym samym wyborze strony kanonicznej. Bing wyjaśnia, że modele językowe łączą prawie identyczne adresy w jedną grupę i mogą wybrać jako reprezentanta nieaktualną stronę. Strona, która nie jest wybranym adresem kanonicznym, ma małe szanse na cytowanie w Copilocie, AI Overviews czy wynikach ChatGPT.
Duplikację treści sprawdzam w każdym audycie SEO, a w projektach międzynarodowego SEO to jeden z najczęstszych problemów.
Najczęstsze pytania: Duplicate content
Czy Google karze za duplicate content?
Google nie karze za zwykłą duplikację treści. Filtruje duplikaty i pokazuje jedną wersję, ale scrapowane treści kopiowane z innych stron bez wartości dodanej mogą naruszać zasady dotyczące spamu.
Czy tłumaczenie strony to duplicate content?
W pełni przetłumaczona strona nie jest duplikatem. Google traktuje strony jako duplikaty tylko wtedy, gdy treść główna jest w tym samym języku, np. gdy przetłumaczono samo menu.
Ile zduplikowanej treści jest dopuszczalne?
Google nie podaje żadnego progu procentowego. Część powtórzeń, np. regulaminy czy specyfikacje produktów, jest normalna; ważne, by każda strona miała jeden jasny adres kanoniczny.
Jak znaleźć duplicate content w serwisie?
Sprawdź raport indeksowania stron w Google Search Console i przecrawluj serwis narzędziem wykrywającym prawie identyczne strony. Oba źródła pokażą, które adresy są łączone w grupy.
Powiązane pojęcia
- What is URL canonicalization · Google Search Central
- How to specify a canonical URL with rel="canonical" and other methods · Google Search Central
- Managing multi-regional and multilingual sites · Google Search Central
- Spam policies for Google web search · Google Search Central
- Does Duplicate Content Hurt SEO and AI Search Visibility? · Bing Webmaster Blog