Co to jest crawl budget?
Crawl budget to ilość pracy, jaką Googlebot poświęca na jedną nazwę hosta. Google traktuje każdą nazwę hosta jako osobny serwis, więc www.sklep.pl i blog.sklep.pl mają osobne budżety. Gdy budżet jest mniejszy niż liczba wartościowych adresów, nowe i zaktualizowane strony dłużej czekają na odwiedziny robota, a to opóźnia indeksację i wzrost pozycji. Inne wyszukiwarki, na przykład Bing, działają z podobnym ograniczeniem, ale termin dotyczy przede wszystkim Google.
Jak działa crawl budget?
Crawl budget to punkt styku między tym, co wytrzyma serwer, a tym, co Google chce pobrać. Dokumentacja Google opisuje dwa elementy.
Limit wydajności indeksowania
Limit wydajności to maksymalna liczba równoległych połączeń i odstęp między pobraniami, z jakimi Googlebot odwiedza serwer. Każdy serwis startuje z tym samym ostrożnym ustawieniem. Limit rośnie, gdy serwer odpowiada szybko, i spada, gdy zwalnia, zwraca błędy 5xx albo kod HTTP 429. Limit jest wspólny dla wszystkich robotów Google, także tych od grafik i reklam.
Zapotrzebowanie na indeksowanie
Zapotrzebowanie to to, jak bardzo Google chce skanować adresy w serwisie. Zależy od 3 czynników:
- Postrzegana liczba adresów: wszystkie URL-e znane Google, razem z duplikatami.
- Popularność: częściej odwiedzane są adresy popularniejsze w sieci.
- Aktualność: Google wraca na strony na tyle często, by wychwycić zmiany.
Migracja serwisu i duże zmiany adresów tymczasowo zwiększają zapotrzebowanie, bo Google musi przeskanować nowe URL-e.
Których serwisów dotyczy crawl budget?
Crawl budget ma znaczenie głównie dla dużych lub często zmieniających się serwisów. Google wymienia trzy grupy:
| Typ serwisu | Próg według Google |
|---|---|
| Duże serwisy | ponad 1 000 000 unikalnych stron zmienianych mniej więcej raz w tygodniu |
| Średnie i większe serwisy | ponad 10 000 unikalnych stron zmienianych codziennie |
| Serwisy z lukami w indeksie | dużo adresów ze statusem „Wykryta, obecnie nie zindeksowana” |
Google podkreśla, że to orientacyjne wartości. Mały blog, którego wpisy trafiają do indeksu w dniu publikacji, nie musi się tym zajmować. W polskich sklepach internetowych najczęstszą przyczyną problemów jest nawigacja fasetowa: filtry rozmiaru, koloru i ceny potrafią zamienić sklep z 20 000 produktów w serwis z milionami adresów.
Jak zoptymalizować crawl budget?
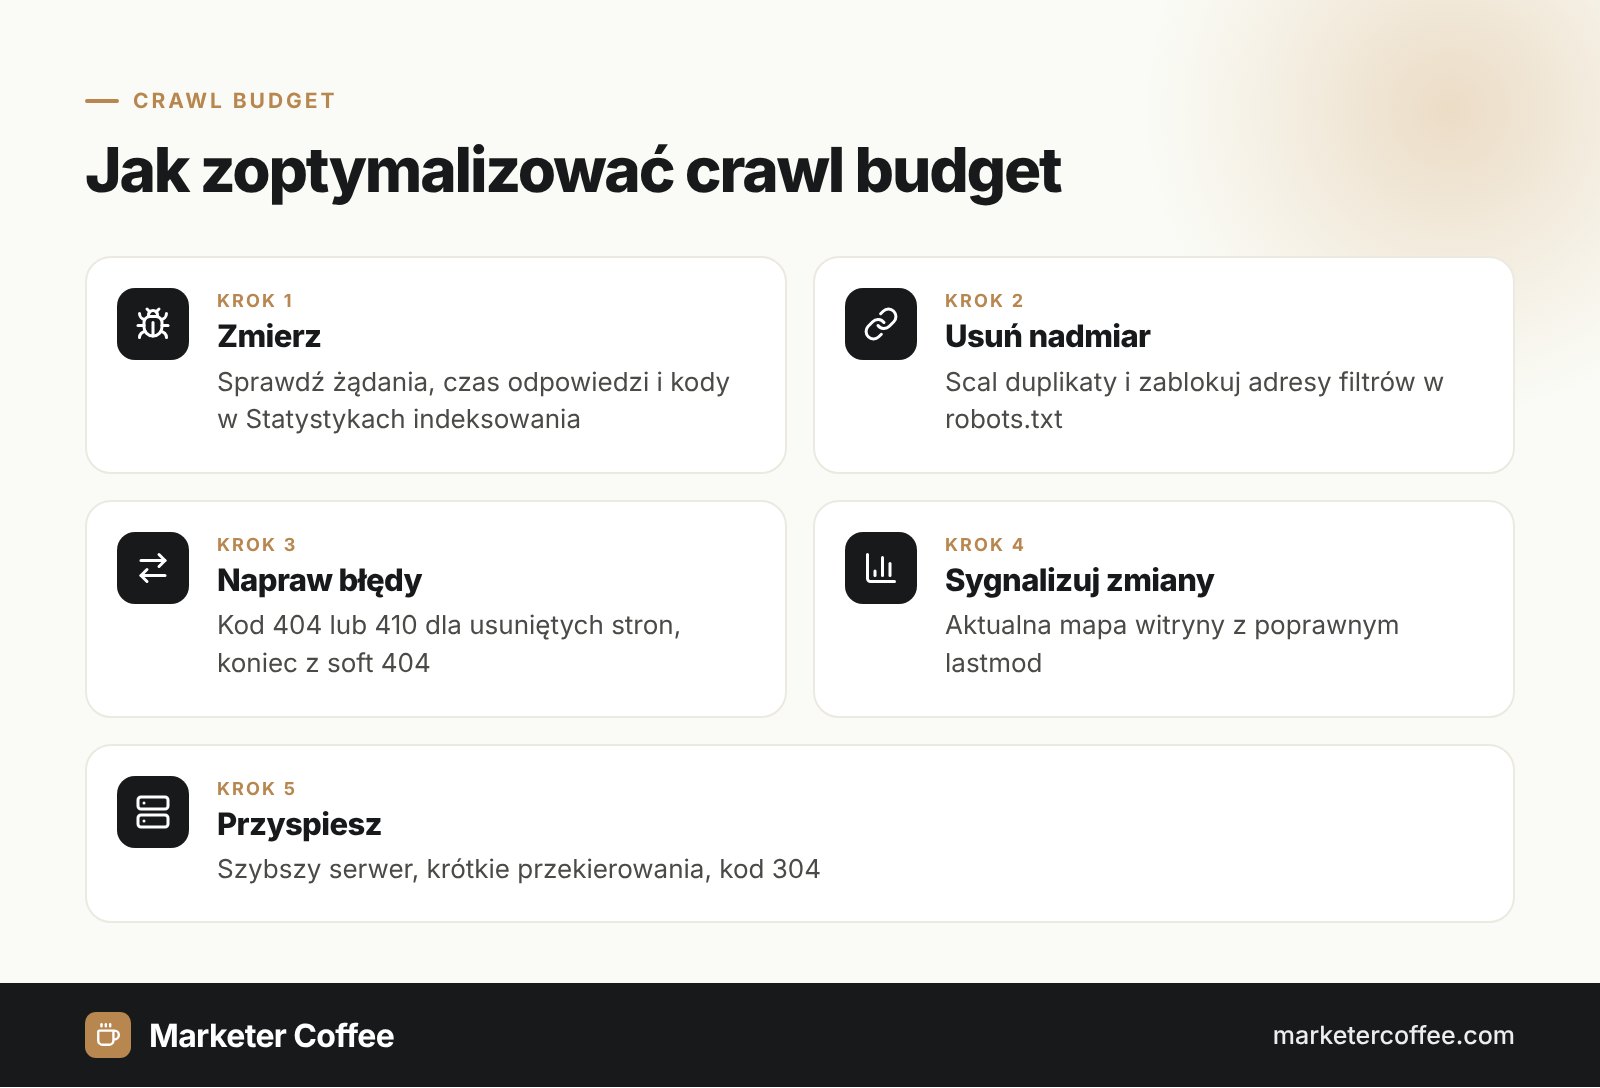
Optymalizacja crawl budgetu polega na usunięciu zbędnych adresów i przyspieszeniu pobierania pozostałych. Google zaleca:
- Scalaj zduplikowane treści i blokuj w robots.txt mało ważne adresy, na przykład kombinacje filtrów.
- Zwracaj kod 404 lub 410 dla trwale usuniętych stron i usuwaj błędy soft 404.
- Aktualizuj mapy XML i podawaj w nich znacznik lastmod.
- Skracaj łańcuchy przekierowań, także przekierowania 302, które powinny być stałe.
- Przyspieszaj odpowiedzi serwera i obsługuj kod 304 Not Modified.
- Ograniczaj ciężkie renderowanie po stronie klienta na stronach ważnych dla SEO.
Warto obalić dwa mity. Tag noindex nie oszczędza budżetu, bo Google i tak musi pobrać stronę, żeby go odczytać. Blokada w robots.txt nie przenosi budżetu na inne strony, chyba że Google już dochodzi do limitu wydajności serwera.
Crawl budget w SEO i wyszukiwaniu AI
Crawl budget ma znaczenie, bo strona, której robot nie odwiedził, nie trafi do indeksu, rankingu ani odpowiedzi AI. AI Overviews i Google AI Mode korzystają z tego samego indeksu, więc wolne skanowanie opóźnia też obecność w odpowiedziach generatywnych. Najmocniej odczuwają to serwisy wielojęzyczne: każda wersja językowa i każdy alternatywny adres w hreflang to osobny URL, więc sklep na 10 rynków ma 10 razy więcej adresów. Dlatego analizę budżetu robię w każdym projekcie międzynarodowego SEO i w audytach SEO dla e-commerce.
Do pomiaru służy raport „Statystyki indeksowania” w Google Search Console (Ustawienia, potem Statystyki indeksowania). Pokazuje liczbę żądań, rozmiar pobranych danych, średni czas odpowiedzi, kody odpowiedzi, cel skanowania i typ Googlebota, a także stan hosta z ostatnich 90 dni.
Najczęstsze pytania: Crawl budget
Czy crawl budget jest czynnikiem rankingowym?
Nie, crawl budget nie jest czynnikiem rankingowym. Decyduje tylko o tym, jak szybko Google znajduje i odświeża strony, a więc jak szybko zmiany mogą wpłynąć na pozycje.
Jak sprawdzić crawl budget w Google Search Console?
Wejdź w Ustawienia i otwórz raport „Statystyki indeksowania”. Zobaczysz dzienną liczbę żądań, czasy odpowiedzi i kody statusu, które razem pokazują, ile i co skanuje Google.
Czy mała strona musi dbać o crawl budget?
Zwykle nie. Według Google serwisom, których nowe strony są skanowane w dniu publikacji, wystarczy aktualna mapa witryny i regularne sprawdzanie raportu indeksowania stron.
Czy noindex oszczędza budżet indeksowania?
Nie, noindex nie oszczędza budżetu. Google musi pobrać stronę, żeby odczytać tag, więc przy ograniczaniu skanowania lepiej użyć robots.txt albo usunąć zbędne adresy.
Powiązane pojęcia
- Optimize your crawl budget (Large site owner's guide to managing your crawl budget) · Google Search Central
- Crawl Stats report · Google Search Console Help