Jak działa robots.txt?
Robots.txt działa jako zbiór reguł crawlowania, które uczciwy robot pobiera i odczytuje, zanim zażąda jakiegokolwiek innego adresu na hoście. Google wskazuje jako główny cel ochronę serwera przed nadmiarem zapytań. Przestrzeganie pliku jest dobrowolne: Googlebot, Bingbot i inne renomowane roboty go respektują, ale scrapery już niekoniecznie, więc nie jest to narzędzie bezpieczeństwa.
Robots.txt steruje crawlowaniem, a nie indeksowaniem. Zablokowany adres może pojawić się w Google, jeśli linkują do niego inne strony, zwykle bez opisu. Żeby wykluczyć stronę z indeksu, użyj noindex i pozwól Google ją przeskanować, aby zobaczył ten tag.
Składnia i reguły robots.txt
Plik robots.txt składa się z grup zaczynających się od linii user-agent, po której następują reguły allow i disallow. Google obsługuje 4 pola: user-agent, allow, disallow i sitemap. Przykład w formie tekstu:
- User-agent: *
- Disallow: /koszyk/
- Disallow: /*?sortuj=
- Allow: /koszyk/pomoc/
- Sitemap: https://example.pl/sitemap.xml
Poniżej najważniejsze zasady interpretacji pliku przez Google.
Lokalizacja i zasięg
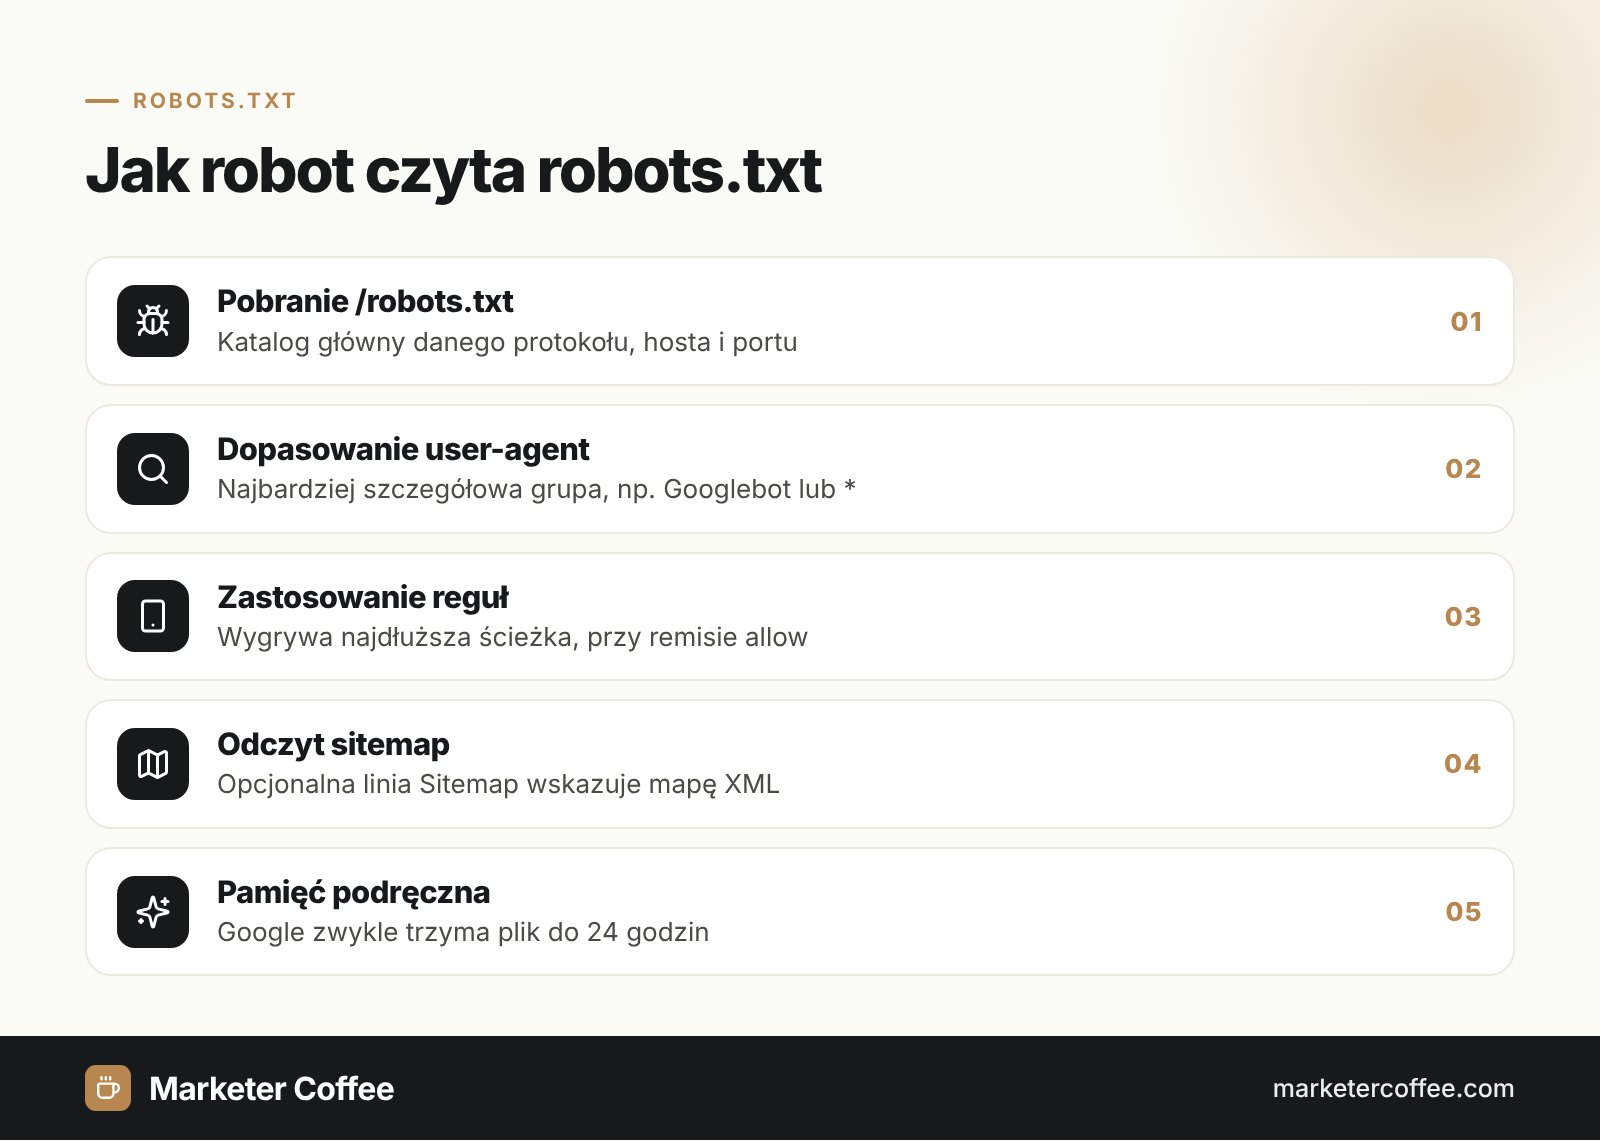
Plik musi leżeć w katalogu głównym hosta, np. https://example.pl/robots.txt. Działa tylko dla tego samego protokołu, hosta i portu, więc sklep.example.pl i example.pl potrzebują osobnych plików.
Symbole wieloznaczne i pierwszeństwo
Gwiazdka oznacza dowolny ciąg znaków, a znak dolara koniec adresu. Wielkość liter w ścieżkach ma znaczenie. Przy konflikcie reguł Google stosuje najbardziej szczegółową (najdłuższą pasującą ścieżkę), a przy remisie tę mniej restrykcyjną.
Kody odpowiedzi HTTP
Odpowiedź 4xx (poza 429) oznacza brak jakichkolwiek ograniczeń. Odpowiedź 5xx powoduje wstrzymanie crawlowania na 12 godzin, a potem używanie ostatniej zapisanej wersji przez maksymalnie 30 dni. Google podąża za maksymalnie 5 przekierowaniami do pliku.
Nieobsługiwane reguły
Google ignoruje w robots.txt dyrektywy crawl-delay, nofollow i noindex. Przestał respektować noindex w tym pliku 1 września 2019 roku, wskazując, że takie reguły były sprzeczne z innymi we wszystkich plikach poza 0,001%. Bing natomiast obsługuje crawl-delay jako względną wartość spowolnienia.
Robots.txt w SEO i wyszukiwarkach AI
W SEO robots.txt jest narzędziem do wydawania budżetu indeksowania na strony, które mają znaczenie: blokowania wyników wyszukiwarki wewnętrznej, niekończących się kombinacji filtrów i koszyka w dużych sklepach, np. na PrestaShopie czy Magento. Nigdy nie blokuj plików CSS i JavaScript potrzebnych do renderowania strony, bo zmienia to sposób, w jaki Google rozumie treść.
W robots.txt kontrolujesz też roboty AI. Google udostępnia token Google-Extended, który decyduje, czy Google może używać Twoich treści do trenowania modeli Gemini i do ugruntowania odpowiedzi w aplikacjach Gemini i Vertex AI. Według Google nie wpływa on na obecność ani pozycje w wyszukiwarce Google. Inne roboty AI przedstawiają się własnymi nazwami user-agent, więc każdego możesz dopuścić lub zablokować w osobnej grupie.
| Cel | Robots.txt? | Lepsze narzędzie |
|---|---|---|
| ograniczenie crawlowania filtrów | tak | reguła Disallow |
| usunięcie strony z Google | nie | noindex lub 404/410 |
| ukrycie prywatnych treści | nie | ochrona hasłem |
| scalenie duplikatów | nie | tag canonical |
Robots.txt w serwisach wielojęzycznych i wielorynkowych
W serwisach międzynarodowych błąd w robots.txt potrafi po cichu wyłączyć z Google cały rynek. Każda domena krajowa i każda subdomena (de.example.com, cz.example.com) potrzebuje własnego pliku, a reguły powinny być spójne między wersjami. Google w wytycznych dla stron adaptujących się do lokalizacji zaleca identyczne reguły robots dla wszystkich wersji. Blokada /de/ zostawiona po etapie testów to błąd, który widziałem po wdrożeniu nowego języka więcej niż raz.
Równie szkodliwe jest blokowanie alternatyw hreflang. Jeśli Google nie może przeskanować wersji niemieckiej, nie potwierdzi linku zwrotnego w zestawie hreflang i adnotacje dla tej pary przepadają. Po każdym wdrożeniu sprawdź pliki dla wszystkich hostów w raporcie robots.txt w Search Console.
Przegląd robots.txt to element każdego projektu technicznego SEO, który prowadzę, oraz audytów SEO międzynarodowego dla serwisów z wieloma domenami. Łącz go z poprawną mapą witryny XML.
Najczęstsze pytania: Robots.txt
Czy robots.txt blokuje indeksowanie strony?
Nie. Robots.txt blokuje crawlowanie, ale zablokowany adres może zostać zaindeksowany, jeśli linkują do niego inne strony. Żeby wykluczyć stronę z Google, użyj noindex i pozwól ją przeskanować.
Gdzie umieścić plik robots.txt?
W katalogu głównym każdego hosta, np. https://example.pl/robots.txt. Każda subdomena i każdy protokół wymagają osobnego pliku.
Czy Google obsługuje crawl-delay?
Nie, Google ignoruje crawl-delay. Bing obsługuje tę dyrektywę jako względną wartość spowolnienia, a Google sam dostosowuje tempo crawlowania do odpowiedzi serwera.
Czy robots.txt zablokuje roboty AI?
Tak, te, które go respektują. Google-Extended kontroluje użycie treści przez modele Gemini, a inne roboty AI możesz blokować po ich własnych nazwach user-agent.
Powiązane pojęcia
- Introduction to robots.txt · Google Search Central
- How Google interprets the robots.txt specification · Google Search Central
- RFC 9309: Robots Exclusion Protocol · IETF / RFC Editor
- A note on unsupported rules in robots.txt · Google Webmaster Central Blog
- Overview of Google crawlers and fetchers (Google-Extended) · Google Search Central
- Crawl delay and the Bing crawler, MSNBot · Bing Webmaster Blog