Jak działa indeksowanie?
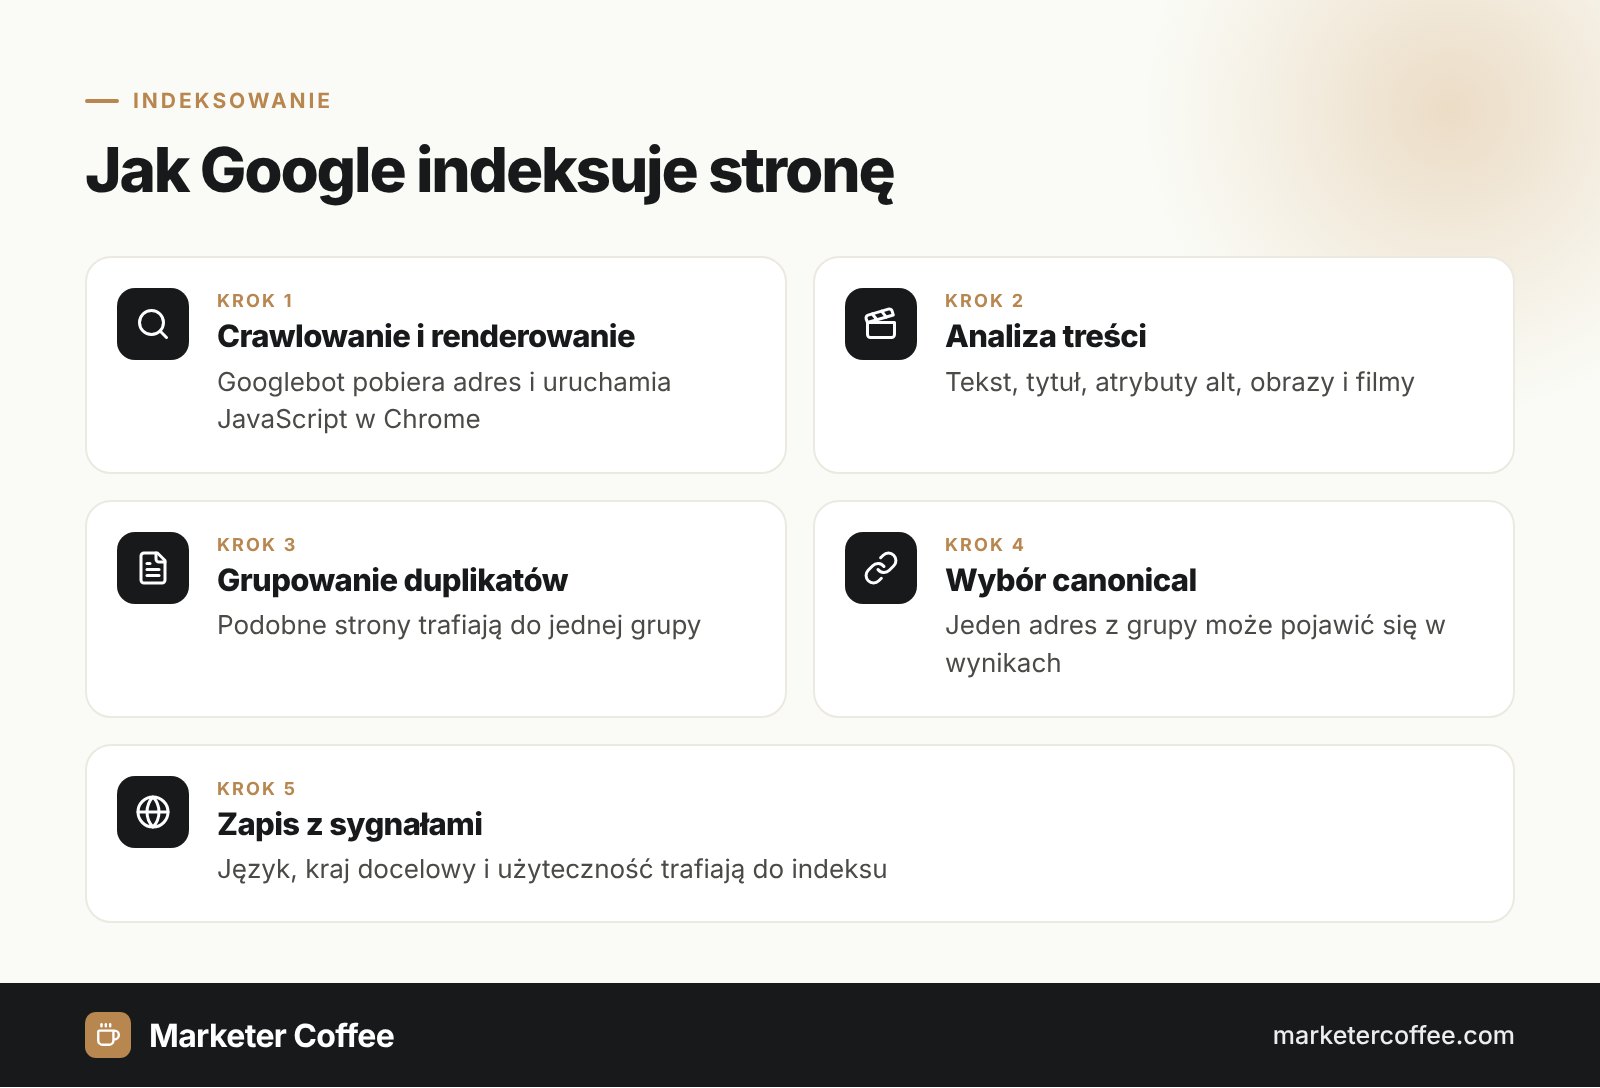
Indeksowanie polega na analizie treści strony, pogrupowaniu duplikatów i wyborze jednego kanonicznego adresu, który zostaje zapisany wraz z sygnałami. Po crawlowaniu i renderowaniu Google przetwarza tekst, kluczowe znaczniki, takie jak tytuł i atrybuty alt, a także obrazy i filmy. Według Google Search Central indeksowanie obejmuje następujące kroki:
- Analiza treści i kluczowych elementów HTML strony.
- Grupowanie stron o tej samej lub bardzo podobnej treści.
- Wybór strony kanonicznej z każdej grupy, czyli tej, która może pojawić się w wynikach.
- Zebranie sygnałów o stronie kanonicznej: języka, kraju docelowego i użyteczności.
- Zapis w indeksie Google na potrzeby wyświetlania wyników.
Crawlowanie, indeksowanie i ranking: różnice
Crawlowanie, indeksowanie i ranking to 3 osobne etapy, a strona może zatrzymać się na każdym z nich:
| Etap | Co się dzieje | Typowa blokada |
|---|---|---|
| Crawlowanie | Googlebot odkrywa i pobiera adres URL | robots.txt, błędy serwera, brak linków |
| Indeksowanie | Google analizuje i zapisuje stronę kanoniczną | noindex, duplikaty, niska jakość |
| Wyświetlanie (ranking) | Google wybiera najtrafniejsze zaindeksowane strony dla zapytania | słaba trafność lub autorytet |
Adres zablokowany w robots.txt może trafić do indeksu bez treści, jeśli Google znajdzie do niego linki w innych miejscach. Żeby wykluczyć stronę z indeksu, pozwól ją crawlować i dodaj dyrektywę noindex.
Najczęstsze statusy indeksowania w Search Console
Raport Indeksowanie stron w Google Search Console pokazuje, które adresy są w indeksie i z jakiego powodu wykluczono każdy pozostały. Statusy, które najczęściej widzę w audytach:
Crawled, currently not indexed (przeskanowana, niezindeksowana)
Google pobrał stronę, ale nie dodał jej do indeksu. Może ją zaindeksować później. W sklepach internetowych ten status zwykle dotyczy ubogich wariantów produktów lub stron kategorii z filtrami.
Discovered, currently not indexed (wykryta, niezindeksowana)
Google zna adres, ale odłożył crawlowanie, często by nie przeciążyć serwera. W dużych serwisach to sygnał ograniczonego budżetu indeksowania lub słabego linkowania wewnętrznego.
Statusy duplikatów
Statusy duplikatów (bez wskazanej strony kanonicznej albo z innym canonicalem wybranym przez Google niż wskazany przez Ciebie) oznaczają, że Google zgrupował stronę z innymi i zaindeksował inny adres. Wybrany canonical sprawdzisz w narzędziu Sprawdzanie adresu URL.
Jak przyspieszyć indeksowanie strony?
Strony indeksują się szybciej, gdy są podlinkowane wewnętrznie, ujęte w mapie witryny XML i warte zaindeksowania. Google daje 2 oficjalne sposoby prośby o crawlowanie: narzędzie Sprawdzanie adresu URL dla pojedynczych stron (z dziennym limitem) i mapę witryny XML dla wielu adresów. Według Google crawlowanie trwa od kilku dni do kilku tygodni, a wielokrotne zgłaszanie tego samego adresu go nie przyspiesza. Google Indexing API działa tylko dla stron z danymi JobPosting lub transmisji na żywo (BroadcastEvent), więc nie jest uniwersalnym skrótem. Bing, Yandex, Seznam.cz, Naver i inne wyszukiwarki obsługują IndexNow, protokół do natychmiastowego zgłaszania nowych, zmienionych i usuniętych adresów. Google nie figuruje na liście uczestników.
Indeksowanie w serwisach wielojęzycznych
W serwisach międzynarodowych indeksowanie przesądza o tym, czy każda wersja językowa w ogóle istnieje w Google. Google traktuje tłumaczenia jako osobne strony, ale uznaje je za duplikaty, gdy przetłumaczono tylko szablon, a główna treść pozostała w jednym języku. Wtedy indeksuje jedną wersję i pomija resztę, a zestaw hreflang się rozpada. Inne częste przyczyny, które znajduję przy ekspansjach do Niemiec i Czech, to canonical z każdej wersji wskazujący stronę polską, automatyczne przekierowania po IP ukrywające wersje przed Googlebotem (który crawluje głównie z USA) i brak nowych rynków w mapie witryny. Indeksowanie każdego rynku sprawdzisz, dodając każdy katalog językowy lub subdomenę jako osobną usługę w Search Console.
Brakuje Twoich stron w Google na którymś rynku? Przyczynę znajdzie audyt SEO albo doradztwo SEO międzynarodowego.
Najczęstsze pytania: Indeksowanie
Ile trwa indeksowanie strony w Google?
Według Google crawlowanie trwa od kilku dni do kilku tygodni. Mocne linkowanie wewnętrzne i aktualna mapa witryny XML pomagają szybciej odkryć nowe podstrony.
Jak sprawdzić, czy strona jest zaindeksowana?
Najdokładniejszą odpowiedź da narzędzie Sprawdzanie adresu URL w Google Search Console. Operator site: w Google daje tylko przybliżony obraz i pomija część zaindeksowanych adresów.
Dlaczego strona jest przeskanowana, ale niezindeksowana?
Google pobrał stronę, ale na razie nie dodał jej do indeksu, często z powodu ubogiej, zduplikowanej lub słabo podlinkowanej treści. Popraw treść i linkowanie zamiast wielokrotnie zgłaszać ten sam adres.
Czy Google obsługuje IndexNow?
Google nie figuruje na liście uczestników IndexNow. Protokół wykorzystują Bing, Yandex, Seznam.cz, Naver i inne wyszukiwarki, a Google opiera się na crawlowaniu, mapach witryny i narzędziu Sprawdzanie adresu URL.
Powiązane pojęcia
- In-depth guide to how Google Search works · Google Search Central
- Page indexing report · Google Search Console Help
- Ask Google to recrawl your URLs · Google Search Central
- Tell Google about localized versions of your page · Google Search Central
- IndexNow FAQ · IndexNow
- Indexing API quickstart · Google Search Central