Jak działa crawlowanie?
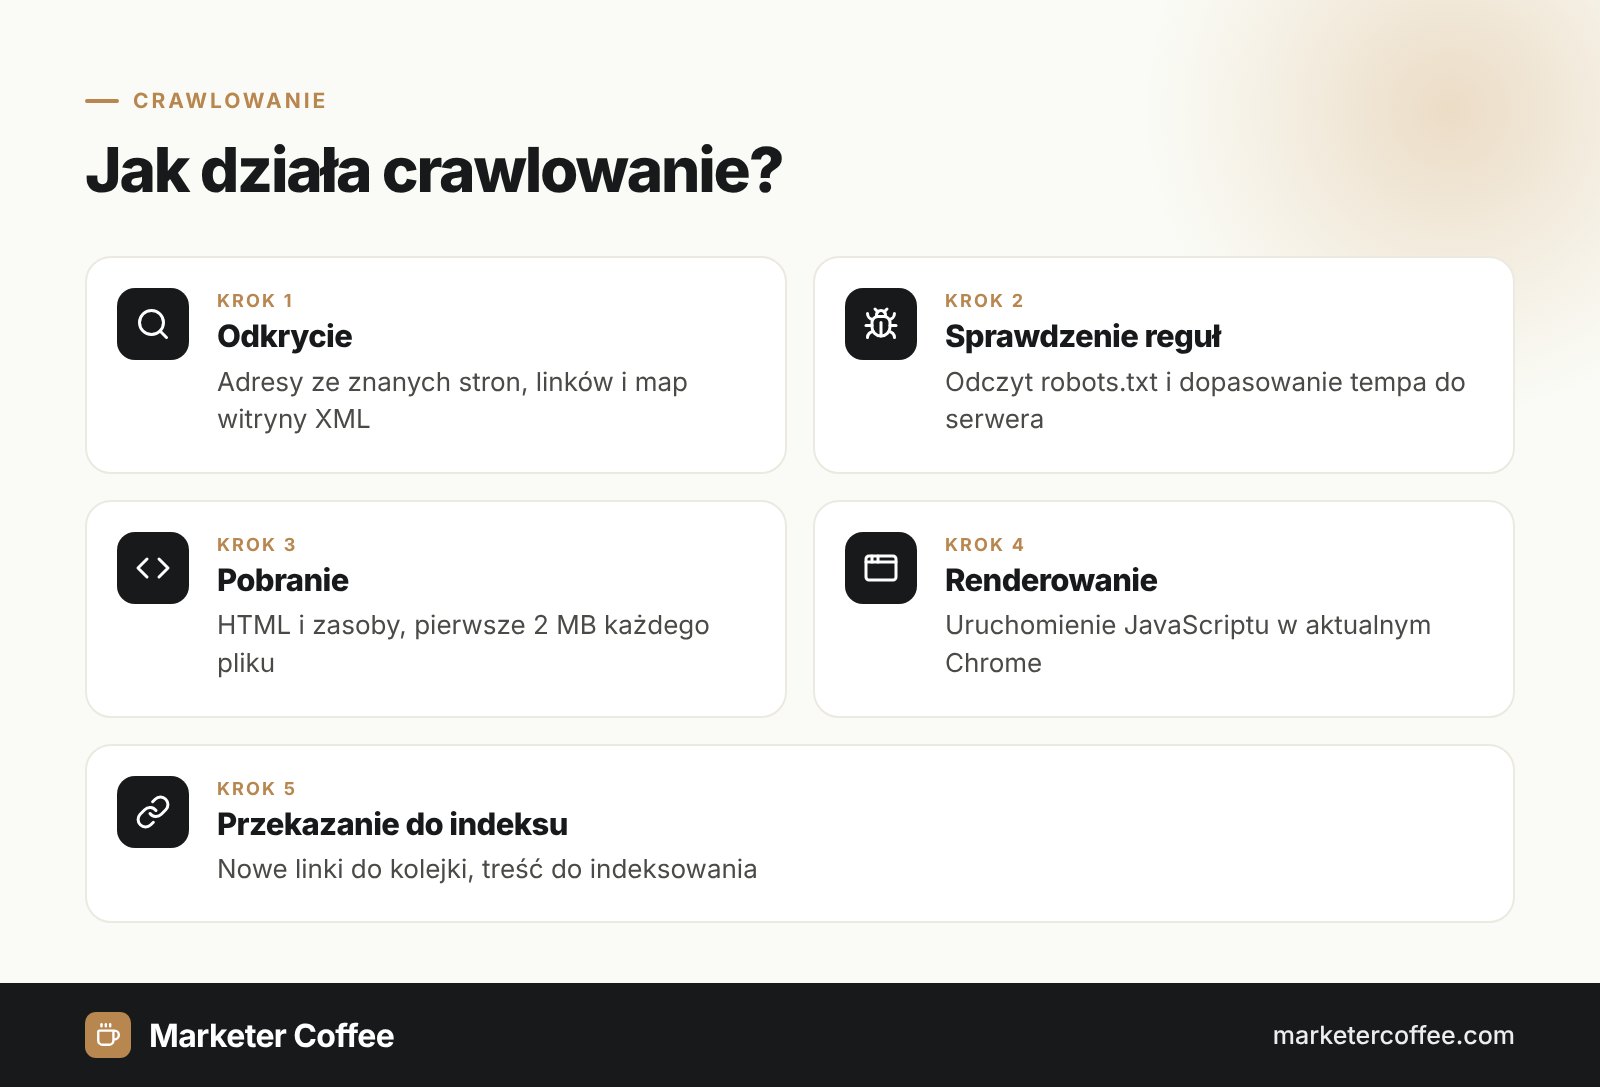
Crawlowanie działa jak pętla: odkrycie adresu, pobranie strony i wyciągnięcie z niej kolejnych linków do odwiedzenia. Google podkreśla, że nie istnieje centralny rejestr stron, więc adresy znajduje na 3 sposoby: wracając na znane strony, podążając za linkami i czytając mapy witryny XML. Algorytm decyduje, które serwisy odwiedzić, jak często i ile stron z nich pobrać.
Odkrywanie
Każdy link wewnętrzny i zewnętrzny to potencjalna ścieżka odkrycia. Strony bez linków przychodzących (sieroty) robot znajdzie najwyżej przez mapę witryny, dlatego linkowanie wewnętrzne to sprawa crawlowania, a nie tylko pozycji.
Pobieranie
Googlebot pobiera HTML i każdy zasób (CSS, JavaScript) osobno, każdy z limitem 2 MB danych nieskompresowanych; dla PDF limit wynosi 64 MB. Według Google Googlebot nie powinien odpytywać większości serwisów częściej niż średnio raz na kilka sekund.
Renderowanie
Podczas crawlowania Google renderuje strony w aktualnej wersji Chrome i uruchamia JavaScript, bo część treści pojawia się dopiero po wykonaniu skryptów.
Crawlowanie a indeksowanie
Crawlowanie i indeksowanie to 2 osobne etapy: crawlowanie pobiera stronę, indeksowanie decyduje, czy ją zapisać. Pobrana strona może nie trafić do indeksu, a strona zablokowana przed robotem może pojawić się w wynikach jako sam adres, jeśli linkują do niej inne serwisy.
| Cecha | Crawlowanie | Indeksowanie |
|---|---|---|
| Co się dzieje | robot pobiera URL | Google analizuje i zapisuje stronę |
| Czym sterujesz | robots.txt, odpowiedzi serwera, linki | noindex, canonical, jakość treści |
| Raport w Search Console | Statystyki indeksowania | Indeksowanie stron |
Do blokowania crawlowania służy robots.txt, a do blokowania indeksowania tag noindex; nie łącz ich na jednym adresie, bo zablokowana strona nie pokaże robotowi tagu noindex. Więcej w haśle indeksowanie.
Co blokuje crawlowanie?
Crawlowanie blokują głównie problemy z serwerem, błędy sieci i reguły robots.txt zabraniające dostępu Googlebotowi, jak podaje Google. Poza zasięgiem są też strony wymagające logowania. Odpowiedzi serwera sterują tempem: powtarzające się błędy 5xx lub kod 429 spowalniają robota, a szybkie i stabilne odpowiedzi pozwalają mu pobierać więcej.
Budżet crawlowania
Budżet crawlowania to liczba adresów, które Google może i chce pobrać z serwisu, wyznaczana przez wydajność serwera i zapotrzebowanie na crawlowanie. Google wskazuje, że ma on znaczenie głównie dla serwisów z ponad milionem unikalnych stron zmieniających się co tydzień lub ponad 10 000 stron zmieniających się codziennie. Duplikaty i adresy z parametrami go marnują, więc zanim obwinisz Google o wolne indeksowanie, przeczytaj hasło crawl budget.
Crawlowanie serwisów wielojęzycznych
Crawlowanie serwisu wielojęzycznego wymaga osobnego, podlinkowanego adresu URL dla każdej wersji językowej i krajowej. Google podaje, że domyślne adresy IP Googlebota wyglądają na amerykańskie i że robot nie wysyła nagłówka Accept-Language. Serwis, który przełącza język po IP lub ustawieniach przeglądarki pod jednym adresem, pokazuje więc Googlebotowi głównie wersję angielską, a treść niemiecka czy polska może nigdy nie zostać pobrana. W projektach międzynarodowych stosuję 3 zasady:
- Osobny adres dla każdej wersji (ccTLD, subdomena lub podkatalog).
- Połączenie wersji przez hreflang i widoczny przełącznik języka.
- Identyczne reguły robots.txt i meta robots we wszystkich wersjach.
Google traktuje każdą nazwę hosta jako osobną witrynę w kontekście budżetu, więc de.sklep.pl i sklep.pl/de/ zachowują się w dużych sklepach inaczej.
Crawlowanie poza Google: Bing, Seznam, IndexNow i boty AI
Inne wyszukiwarki również crawlują, a część przyjmuje powiadomienia. Protokół IndexNow pozwala zgłosić nowe lub zmienione adresy do Microsoft Bing, Naver, Seznam.cz, Yandex i Yep, do 10 000 adresów w jednym żądaniu, a wyszukiwarki dzielą się zgłoszeniami między sobą. Przy wejściu polskiego sklepu do Czech to ważne, bo Seznam uczestniczy w IndexNow. Strony pobierają też boty AI od OpenAI, Anthropic czy Perplexity, więc ich zablokowanie w robots.txt usuwa Twoje treści z odpowiedzi tych asystentów; sprawdzam te reguły w ramach AI SEO (GEO).
Nie masz pewności, czy Google widzi wszystkie Twoje rynki? Techniczne SEO i doradztwo w zakresie międzynarodowego SEO zaczynam od analizy crawlowania.
Najczęstsze pytania: Crawlowanie
Czym różni się crawlowanie od indeksowania?
Crawlowanie to pobranie strony przez robota, a indeksowanie to jej analiza i zapisanie w bazie wyszukiwarki. Strona może zostać pobrana, ale nie trafić do indeksu, jeśli Google uzna ją za duplikat lub mało wartościową.
Jak sprawić, by Google zeskanował moją stronę?
Podlinkuj nowe podstrony z już zaindeksowanych stron, dodaj je do mapy witryny XML i zgłoś ją w Search Console. Pojedyncze pilne adresy zgłoś przez narzędzie Sprawdzanie adresu URL.
Jak często Googlebot odwiedza stronę?
Googlebot odwiedza każdy serwis we własnym tempie, zależnym od wydajności serwera, popularności i częstotliwości zmian treści. W większości serwisów to średnio nie więcej niż jedno żądanie co kilka sekund.
Czy robots.txt usuwa stronę z Google?
Nie, robots.txt blokuje crawlowanie, a nie indeksowanie. Zablokowany adres może pojawić się w wynikach, jeśli linkują do niego inne strony, dlatego do wykluczenia z indeksu użyj tagu noindex na dostępnej dla robota stronie.
Powiązane pojęcia
- In-depth guide to how Google Search works · Google Search Central
- Googlebot · Google Search Central
- Crawl budget management for large sites · Google Search Central
- How Google crawls locale-adaptive pages · Google Search Central
- IndexNow documentation · IndexNow.org