Jak działa duży model językowy?
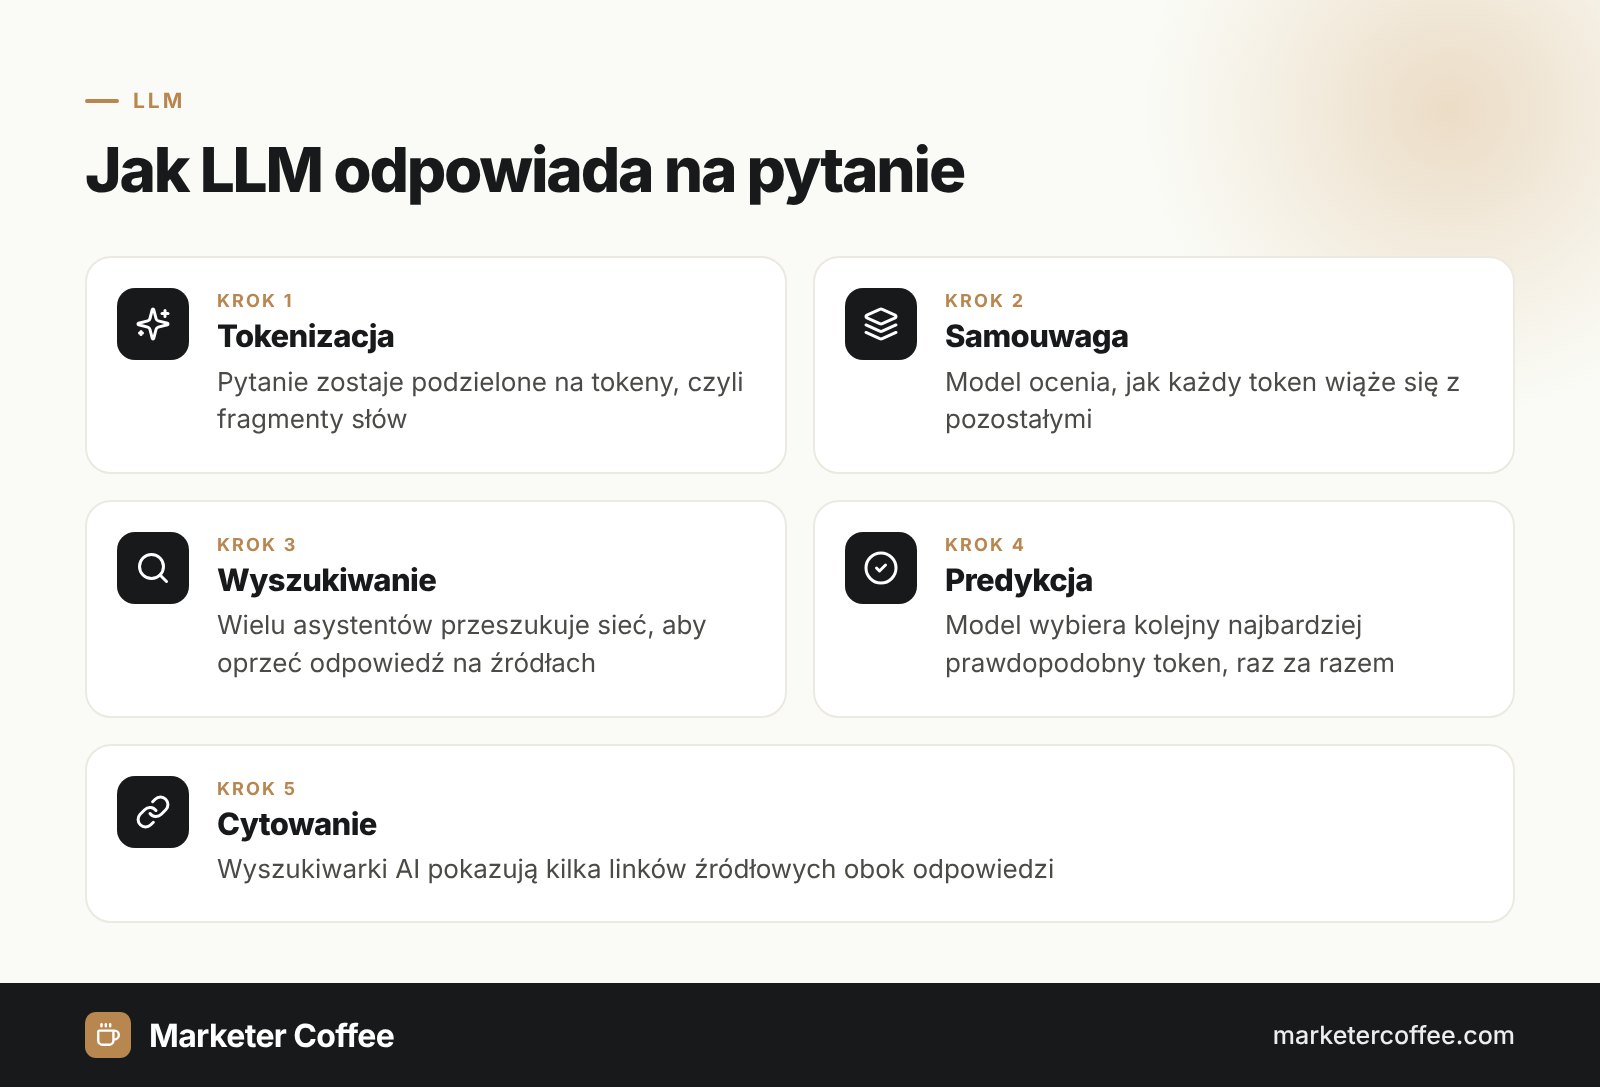
Duży model językowy działa w ten sposób, że przypisuje prawdopodobieństwo każdemu możliwemu kolejnemu tokenowi i wybiera jeden, krok po kroku. Token to fragment tekstu: całe słowo, jego część albo pojedynczy znak. Polszczyzna, bogata w odmiany, zwykle zużywa więcej tokenów na słowo niż angielski, co wpływa na koszt korzystania z API. Google opisuje LLM jako bardzo zaawansowane autouzupełnianie, które dopisuje zdanie, akapit lub odpowiedź token po tokenie.
Architektura LLM: Transformer
Współczesne LLM zbudowane są na Transformerze, architekturze opartej wyłącznie na mechanizmie uwagi. Ashish Vaswani, Noam Shazeer i współpracownicy z Google opisali ją w pracy „Attention Is All You Need”, opublikowanej w serwisie arXiv 12 czerwca 2017 roku. Trzy elementy poniżej wyjaśniają, dlaczego wyparła starsze sieci rekurencyjne.
Mechanizm samouwagi (self-attention)
Samouwaga pozwala modelowi ocenić, jak bardzo każdy inny token wpływa na znaczenie bieżącego. Dzięki temu w zdaniu „Pies nie przeszedł przez ulicę, bo był zmęczony” model łączy słowo „był” z psem, a nie z ulicą.
Enkoder i dekoder
Enkoder zamienia tekst na liczbowe reprezentacje zwane embeddingami, a dekoder zamienia je z powrotem na tekst. Czatboty korzystają głównie z modeli typu „tylko dekoder”, a modele enkoderowe sprawdzają się w wyszukiwaniu i klasyfikacji.
Parametry i okno kontekstu
Parametry to wyuczone wagi sieci, a okno kontekstu to liczba tokenów, które model czyta jednocześnie. Aktualne modele Claude od Anthropic przyjmują na przykład 1 mln tokenów kontekstu.
Jak trenuje się modele LLM?
Modele LLM trenuje się w kilku etapach, od surowego tekstu do pomocnych odpowiedzi:
- Pretrening: model uczy się przewidywać tokeny na gigantycznym korpusie tekstów, co zajmuje miesiące obliczeń.
- Dostrajanie instrukcyjne: model uczy się wykonywać polecenia na przykładach pytań i odpowiedzi.
- Uczenie ze wzmocnieniem na podstawie opinii ludzi (RLHF): ludzie oceniają odpowiedzi, a model nagrody koryguje LLM, tak jak OpenAI zrobiło przy ChatGPT w listopadzie 2022 roku.
- Wyszukiwanie i narzędzia: gotowy model przeszukuje internet lub bazę danych, aby oprzeć odpowiedź na aktualnych faktach.
Przykłady dużych modeli językowych
| Rodzina modeli | Twórca | Produkt |
|---|---|---|
| GPT | OpenAI | ChatGPT |
| Claude | Anthropic | Claude |
| Gemini | aplikacja Gemini, AI Overviews, AI Mode | |
| PLLuM | Ministerstwo Cyfryzacji i konsorcjum pod kierunkiem Politechniki Wrocławskiej | polskie modele od 8 do 70 mld parametrów |
| Bielik | polski zespół badawczy | model rozwijany równolegle z PLLuM |
LLM w marketingu, SEO i wyszukiwaniu AI
LLM są ważne dla marketerów, bo piszą odpowiedź, zanim użytkownik zobaczy jakikolwiek link. AI Overviews w Google i samodzielni asystenci pobierają strony, streszczają je i cytują tylko kilka źródeł. Optymalizację pod ten etap nazywamy Generative Engine Optimization.
W moich projektach SEO z działania LLM wynikają trzy praktyczne zasady:
- Odpowiadaj na pytanie w pierwszym zdaniu pod każdym nagłówkiem, bo systemy wyszukiwania tną strony na krótkie fragmenty.
- Nazywaj encje wprost (firmy, produkty, miejsca), bo modele łączą fakty właśnie przez encje.
- Podawaj dokładne liczby ze źródłem, bo LLM chętniej cytują weryfikowalne stwierdzenia.
Te zasady wdrażam w każdym projekcie AI SEO, razem z planem SEO opartego na encjach.
Ograniczenia dużych modeli językowych
Głównym ograniczeniem LLM jest to, że potrafią tworzyć płynne, ale nieprawdziwe zdania, czyli halucynacje. Google wymienia też wysokie koszty treningu i działania, uprzedzenia przejęte z danych treningowych oraz otwarte pytania o zdolność uogólniania. Dla zespołu marketingu oznacza to, że każdą statystykę z tekstu napisanego przez AI trzeba sprawdzić przed publikacją.
Najczęstsze pytania: LLM
Co oznacza skrót LLM?
LLM to skrót od angielskiego large language model, czyli duży model językowy. To model AI wytrenowany na bardzo dużych zbiorach tekstu, który przewiduje i generuje język.
Czy ChatGPT to LLM?
ChatGPT to aplikacja zbudowana na modelach językowych GPT firmy OpenAI. Sam tekst generuje LLM, a produkt ChatGPT dodaje interfejs czatu, narzędzia i wyszukiwanie w sieci.
Czy istnieje polski model językowy?
Tak, w lutym 2025 roku Ministerstwo Cyfryzacji udostępniło PLLuM, rodzinę polskich modeli od 8 do 70 mld parametrów. Budowało je konsorcjum 6 instytucji pod kierunkiem Politechniki Wrocławskiej, a obok rozwija się model Bielik.
Dlaczego LLM halucynują?
LLM halucynują, bo generują najbardziej prawdopodobną kontynuację tekstu, a nie zweryfikowany fakt. Oparcie odpowiedzi na pobranych źródłach zmniejsza to ryzyko, ale go nie usuwa.
Powiązane pojęcia
- LLMs: What's a large language model? · Google for Developers
- Introduction to Large Language Models · Google for Developers
- Attention Is All You Need · arXiv (Vaswani et al.)
- Introducing ChatGPT · OpenAI
- Models overview · Anthropic
- Ministerstwo Cyfryzacji ogłasza PLLuM, rodzinę polskich modeli sztucznej inteligencji · iMagazine